NFAを使用せずに正規表現からDFAを作成する方法は?


12

目的は、正規表現からDFAを作成することであり、「通常のexp> NFA> DFA変換」を使用することはオプションではありません。それをどのように行うべきですか?

私は教授にこの質問をしましたが、彼は私たちが直観を使うことができると言って、親切に説明を拒否しました。だから私はあなたに尋ねたかった。

「通常のexp> NFA> DFA変換」はオプションではありません。そのような変換は、かなり複雑な正規表現を変換するのに多くの時間がかかるからです。たとえば、特定の正規表現「regex> NFA> DFA」の場合、人間には1時間かかります。30分以内に正規表現をDFAに変換する必要があります。


2
より多くのコンテキストを提供する必要があります。正規表現の翻訳に現在使用している(非公式の)アルゴリズムは何ですか?などの例を使用してプロセスを説明すると役立つ場合がありますa(a|ab|ac)*a+。これをNDFAに直接変換してDFAに変換するか、DFAにすぐにマッピングされるものに正規化することができます。
— アモン

何らかの方法で特定の例でそれを行う必要がありますか、それともコンピュータによって適用される一般的な手順を提供する必要がありますか?
— -babou

回答:


18

「30分以内に正規表現をDFAに変換する」ことを望んでいるので、比較的小さな例を手作業で作業していると思います。

この場合、Brzozowskiのアルゴリズム 使用できます。このアルゴリズムは、言語のNerodeオートマトン(最小決定論的オートマトンに等しいことが知られています)を直接計算します。これは導関数の直接計算に基づいており、交差および補完を可能にする拡張正規表現でも機能します。このアルゴリズムの欠点は、途中で計算される式の等価性をチェックする必要があることです。これは高価なプロセスです。しかし、実際には、小さな例では、非常に効率的です。[1]

左商。してみましょう言語もとlet言葉も。次いで、 言語呼び出され、左商を(または誘導体左)の。A * U U - 1 L = { V ∈ A * | UがV ∈ L } U - 1 LのLLA∗あなたは

あなたは−1L={v∈A∗∣あなたはv∈L}
あなたは−1LL

Nerodeさんオートマトン。のNerodeオートマトンは決定論的オートマトンですここで、そして、遷移関数は、各に対して、式によって 定義されます このかなり抽象的な定義に注意してください。各状態は、単語による左商であり、したがって言語です。初期状態は言語であり、最終状態のセットはすべての左商のセットです。LA(L)=(Q、A、⋅、L、F)Q={あなたは−1L∣あなたは∈A∗}F={あなたは−1L∣あなたは∈L}a∈A

(あなたは−1L)⋅a=a−1(あなたは−1L)=(あなたはa)−1L
ALA∗LLの言葉によって、。L

Brzozowskiのアルゴリズム。ましょう手紙も。次の式を使用して左商を計算できます。 a,b

a−11=0a−1b={1if a=b0if a≠ba−1(L1∪L2)=a−1L1∪u−1L2,a−1(L1∖L2)=a−1L1∖u−1L2,a−1(L1∩L2)=a−1L1∩u−1L2,a−1L∗=(a−1L)L∗
a−1(L1L2)={(a−1L1)L2si 1∉L1,(a−1L1)L2∪a−1L2si 1∈L1

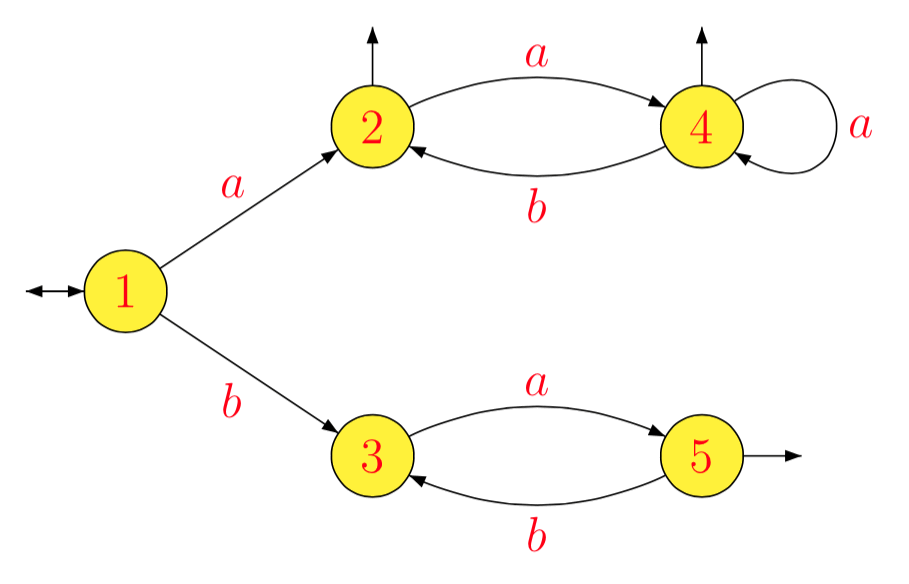
例。用、我々は連続し得る: 以下の最小限のオートマトンを提供します。 L=(a(ab)∗)∗∪(ba)∗

1−1L=L=L1a−1L1=(ab)∗(a(ab)∗)∗=L2b−1L1=a(ba)∗=L3a−1L2=b(ab)∗(a(ab)∗)∗∪(ab)∗(a(ab)∗)∗=bL2∪L2=L4b−1L2=∅a−1L3=(ba)∗=L5b−1L3=∅a−1L4=a−1(bL2∪L2)=a−1L2=L4b−1L4=b−1(bL2∪L2)=L2∪b−1L2=L2a−1L5=∅b−1L5=a(ba)∗=L3
最小のオートマトン

[1] J.ブルゾゾフスキー、正規表現の派生物、J.ACM 11(4)、481–494、1964。

編集。(2015年4月5日)同様の質問を発見しました:特定の正規表現で記述された言語を認識するDFAを構築するためのアルゴリズムは何ですか?cstheoryで尋ねられました。答えは部分的に複雑さの問題に対処します。


このアルゴリズムの複雑さについて詳しく説明できますか?
— バブー

@babou REをDFAに変換することはPSPACEに難しいため、間違いなく指数関数的です。
— jmite

これはおそらく答えに入るはずです。OPは「NFAを介した標準構成が遅すぎる」から始まり、答えの一部は「不運、本当に速い解決策はない」と思われます。ここでこれが標準的な構造よりも優れているかどうかを議論する必要があります。(cc @jmite)
— ラファエル

@jmiteはい、私はそれを期待していました。私の質問の理由は、DFAを構築するこの方法を簡単に考えるべき理由です。(注:システムが@ jmiteの回答を通知するのに丸1日かかりました)。
— babou

2

J.-E. ピンは形式と完全性の点でより良い答えを提供しますが、あなたの教授が示唆している「直感」のために言わなければならないことがあると思います。

これらのほとんどの場合、最も簡単なことは、正規表現を見て、受け入れている言語を理解し、創造性/賢さを使用してその言語を受け入れるDFAを構築することです。

他の人が与えたアルゴリズム以外に、これを行う簡単な方法はありませんが、ここに役立つと思われるいくつかのガイドラインがあります。

  1. ブール値または非常に小さな整数変数のみを使用してこのREを受け入れるプログラムを作成できますか?次に、そのプログラムを作成し、値のすべての組み合わせの状態があるDFAに変換します。

  2. 「これが表示された場合、REのこの部分と一致している必要があります」とわかっている、確定的に受け入れることができるとわかっている正規表現の部分を探します。これらは常に大量にあるとは限りませんが、これらのパーツを特定することで、DFAを簡単に作成できるパーツを示すことができるため、非決定性を本当に必要とするパーツにより多くの時間を費やすことができます。

  3. NFA-> DFAのサブセット構築は、実際にはそれほど複雑なアルゴリズムではありません。したがって、これが試験問題ではなく課題である場合は、実装をコーディングして、プログラムでNFAをDFAに変換する方が速い場合があります。独自のコードを使用した場合、盗用の問題はないはずです。

P=NP=PSPACE

アルゴリズムが多くのステップを必要とするが、結果が明らかな場所で直感を使用できる場合は、「先読み」してコーナーを切ります。


-2

これは正しい方法ではありませんが、ほとんどの場合に機能します。

最初のステップ:正規表現で受け入れられる最小の文字列を見つけます。 2番目のステップ:最小文字列受け入れマシンのトランザクションで必要な状態を描画します。 3番目のステップ:すべての州で、残りのアルファベットトランザクションを描画します。

例:正規表現(0 + 1)* 1 "1で終わる文字列"ステップ1:最小の文字列:1ステップ2:2つの状態Q0およびQ1。Q0からQ1に1のトランザクションがあります。Q1は受け入れ状態です。ステップ3:Q0状態の場合Q0 1トランザクションはQ1になります。Q0自体で0トランザクションを作成します。Q1状態の場合、Q1 1トランザクションはQ1に残ります。そして、0トランザクションはQ0に進みます。

弊社のサイトを使用することにより、あなたは弊社のクッキーポリシーおよびプライバシーポリシーを読み、理解したものとみなされます。
Licensed under cc by-sa 3.0 with attribution required.